为 RSI 准备的 Deepseek Harness
从 AGI 路线图到 RSI
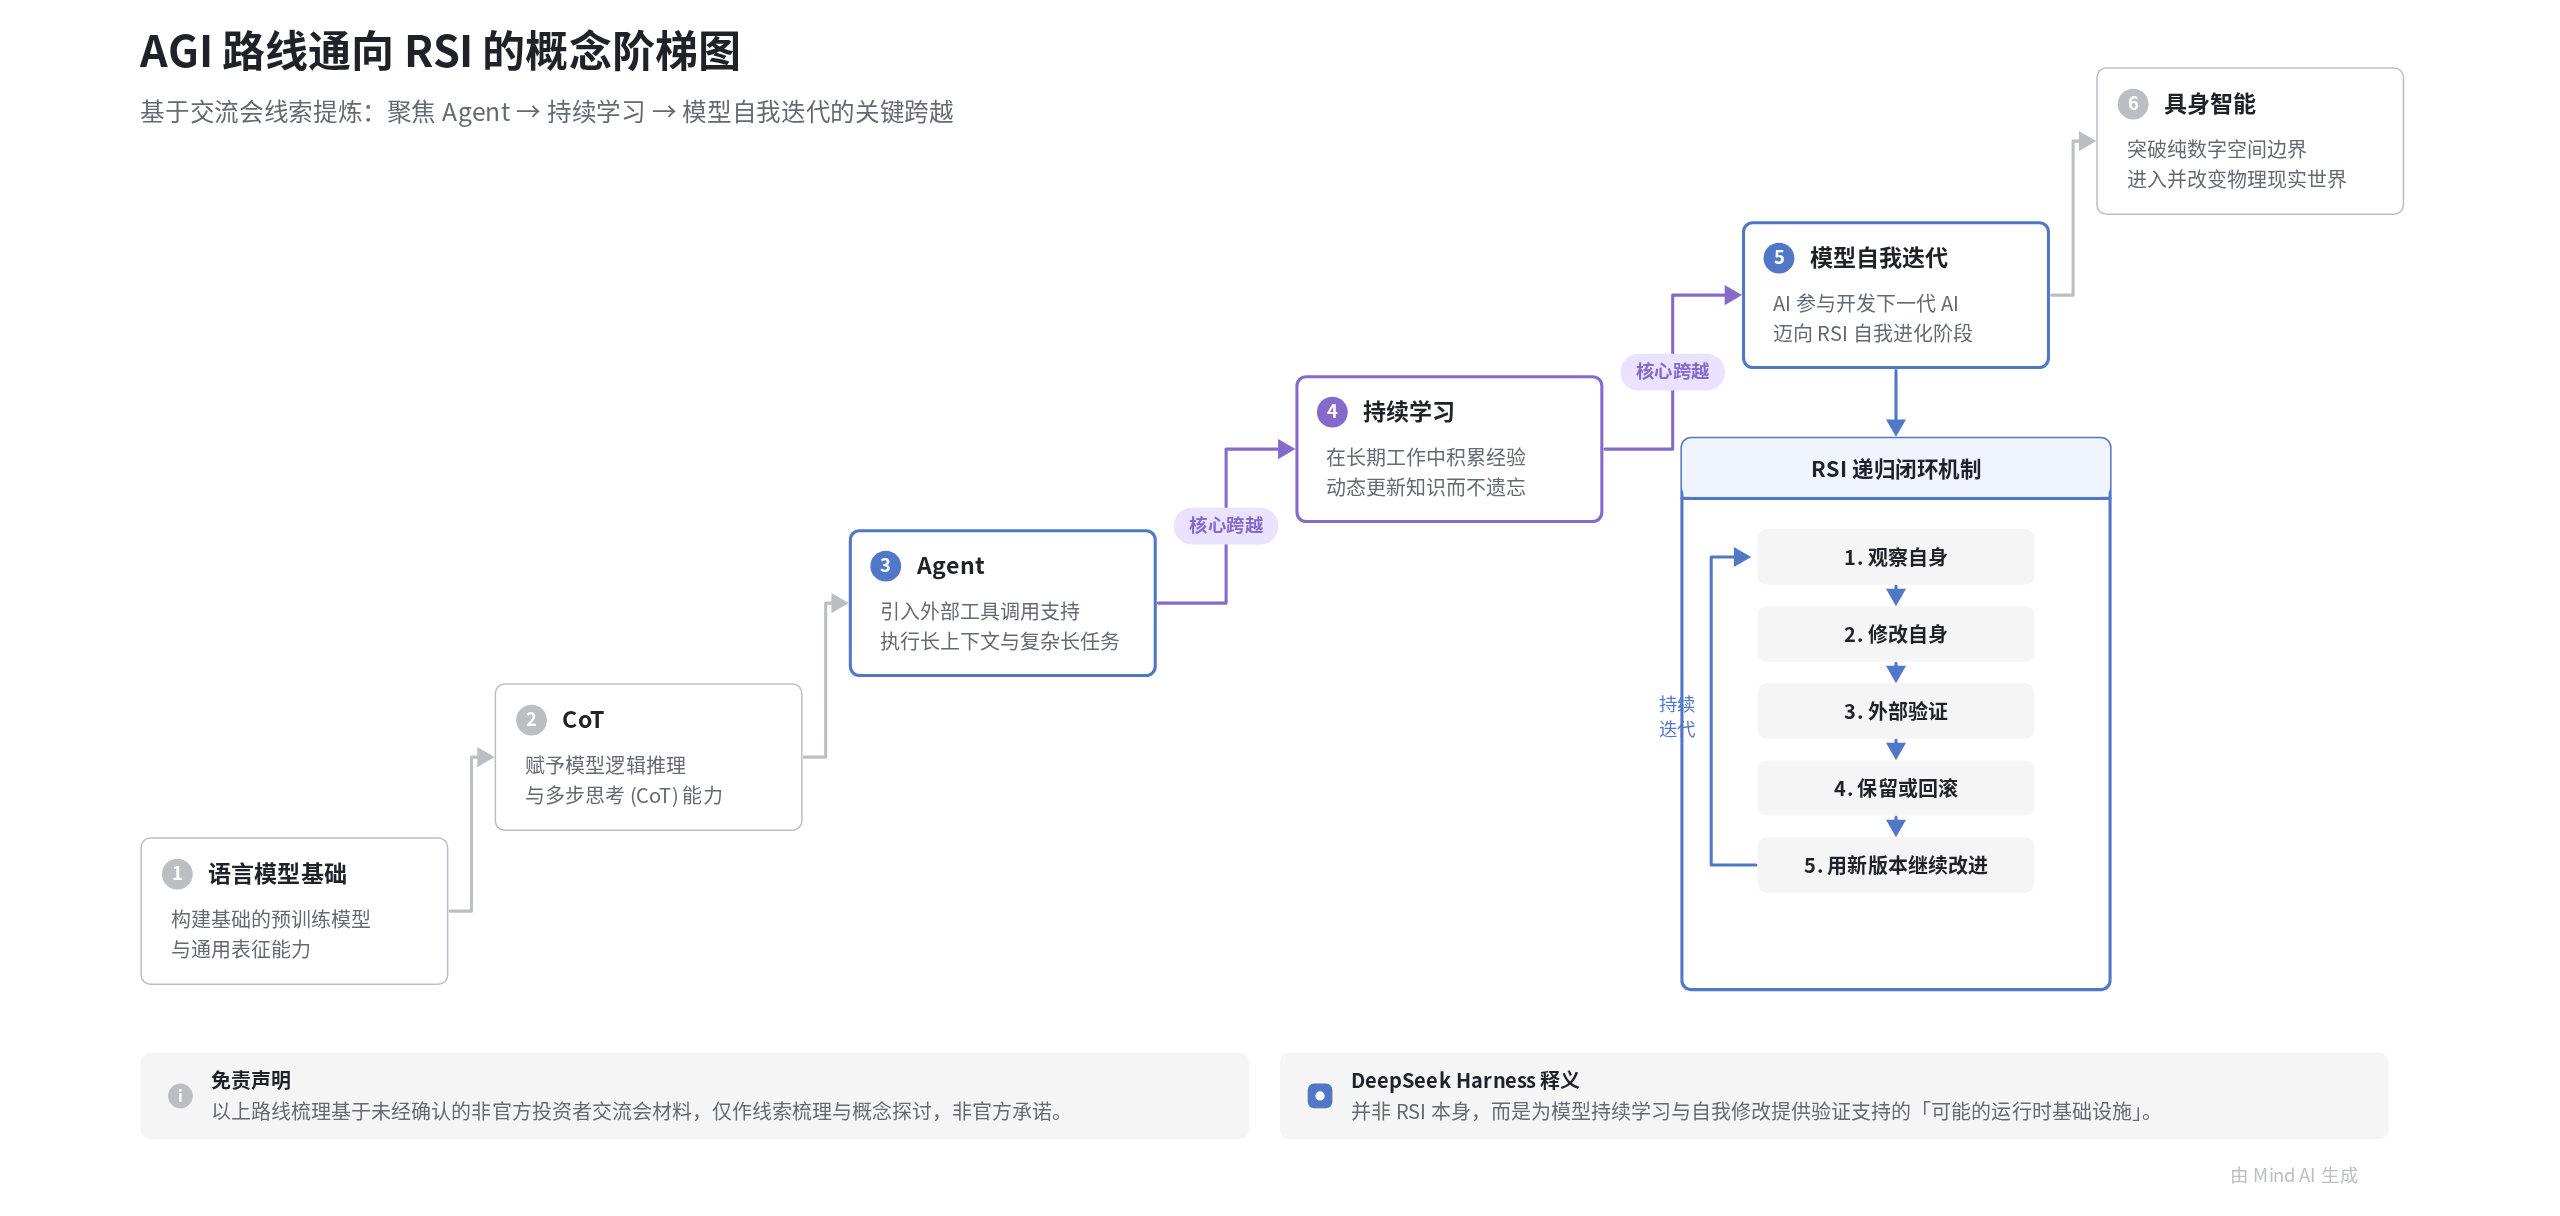
前段时间,一份梁文锋投资者交流会录音文字稿在行业里流传。融资、开源和商业化之外,其中有一段很适合和刚刚开源的 DeepSeek Harness 放在一起看。
按照这份文字稿的整理,梁文锋把通往 AGI 的路线描述成几级台阶:先是 CoT,让模型学会展开思考;再是 Agent,让模型能够使用工具完成更长的任务;Agent 之后要解决持续学习;持续学习之后,模型开始参与开发下一代模型,AI 加速 AI 研究;再往后才是具身智能。
文字稿里还有一句很直接的话:DeepSeek 希望下一代模型先帮助自己的开发。
如果模型只是帮工程师写代码,这还是普通的 AI 辅助开发。如果它能观察自己的运行方式,提出修改,验证修改是否有效,再把有效改动带进下一轮,事情就开始接近 RSI。
RSI 是 Recursive Self-Improvement,通常译作“递归自我改进”。它指的不是一次自我修改,而是一个连续过程:
-
系统发现自己的问题;
-
系统修改自身的一部分;
-
修改后的系统通过外部测试;
-
有效改动被保留,失败改动被撤回;
-
新版本以更强的能力继续下一轮改进。
这里真正重要的是最后一步。一次修改不叫递归;修改后的系统变得更善于继续修改自己,才可能形成正反馈。
模型之外,还需要一个能被改造的 Harness
今天大多数 Agent 都可以改代码,却很少能安全地修改“自己为什么这样工作”。
模型负责推理,但模型外面还有一整套运行环境:系统提示词、工具、权限、记忆、任务循环、子 Agent、沙箱、持久化和界面。这些部分共同组成 Harness。DeepSeek 官方页面把两者的关系写得很简单:
| Agent = Model + Harness |
普通 Agent 的 Harness 通常是固定的。模型可以在工作区里改业务代码,却不能轻易替换自己的工具、调整自己的任务循环,或者增加一种新的记忆方式。即便能改,修改也经常散落在配置、代码和进程状态里,很难验证,更难回滚。
RSI 需要的 Harness 不太一样。它至少要允许系统回答五个问题:
-
我现在是怎么运行的?
-
哪一部分限制了我?
-
我能不能只修改这一部分?
-
修改后到底有没有变好?
-
如果变差了,能不能退回去?
这也是 DeepSeek Harness 值得关注的地方。它没有把 Harness 当成模型外面的一层固定胶水,而是把 Harness 自身也变成了可以组合和替换的对象。
DeepSeek Harness 为自我改进准备了什么
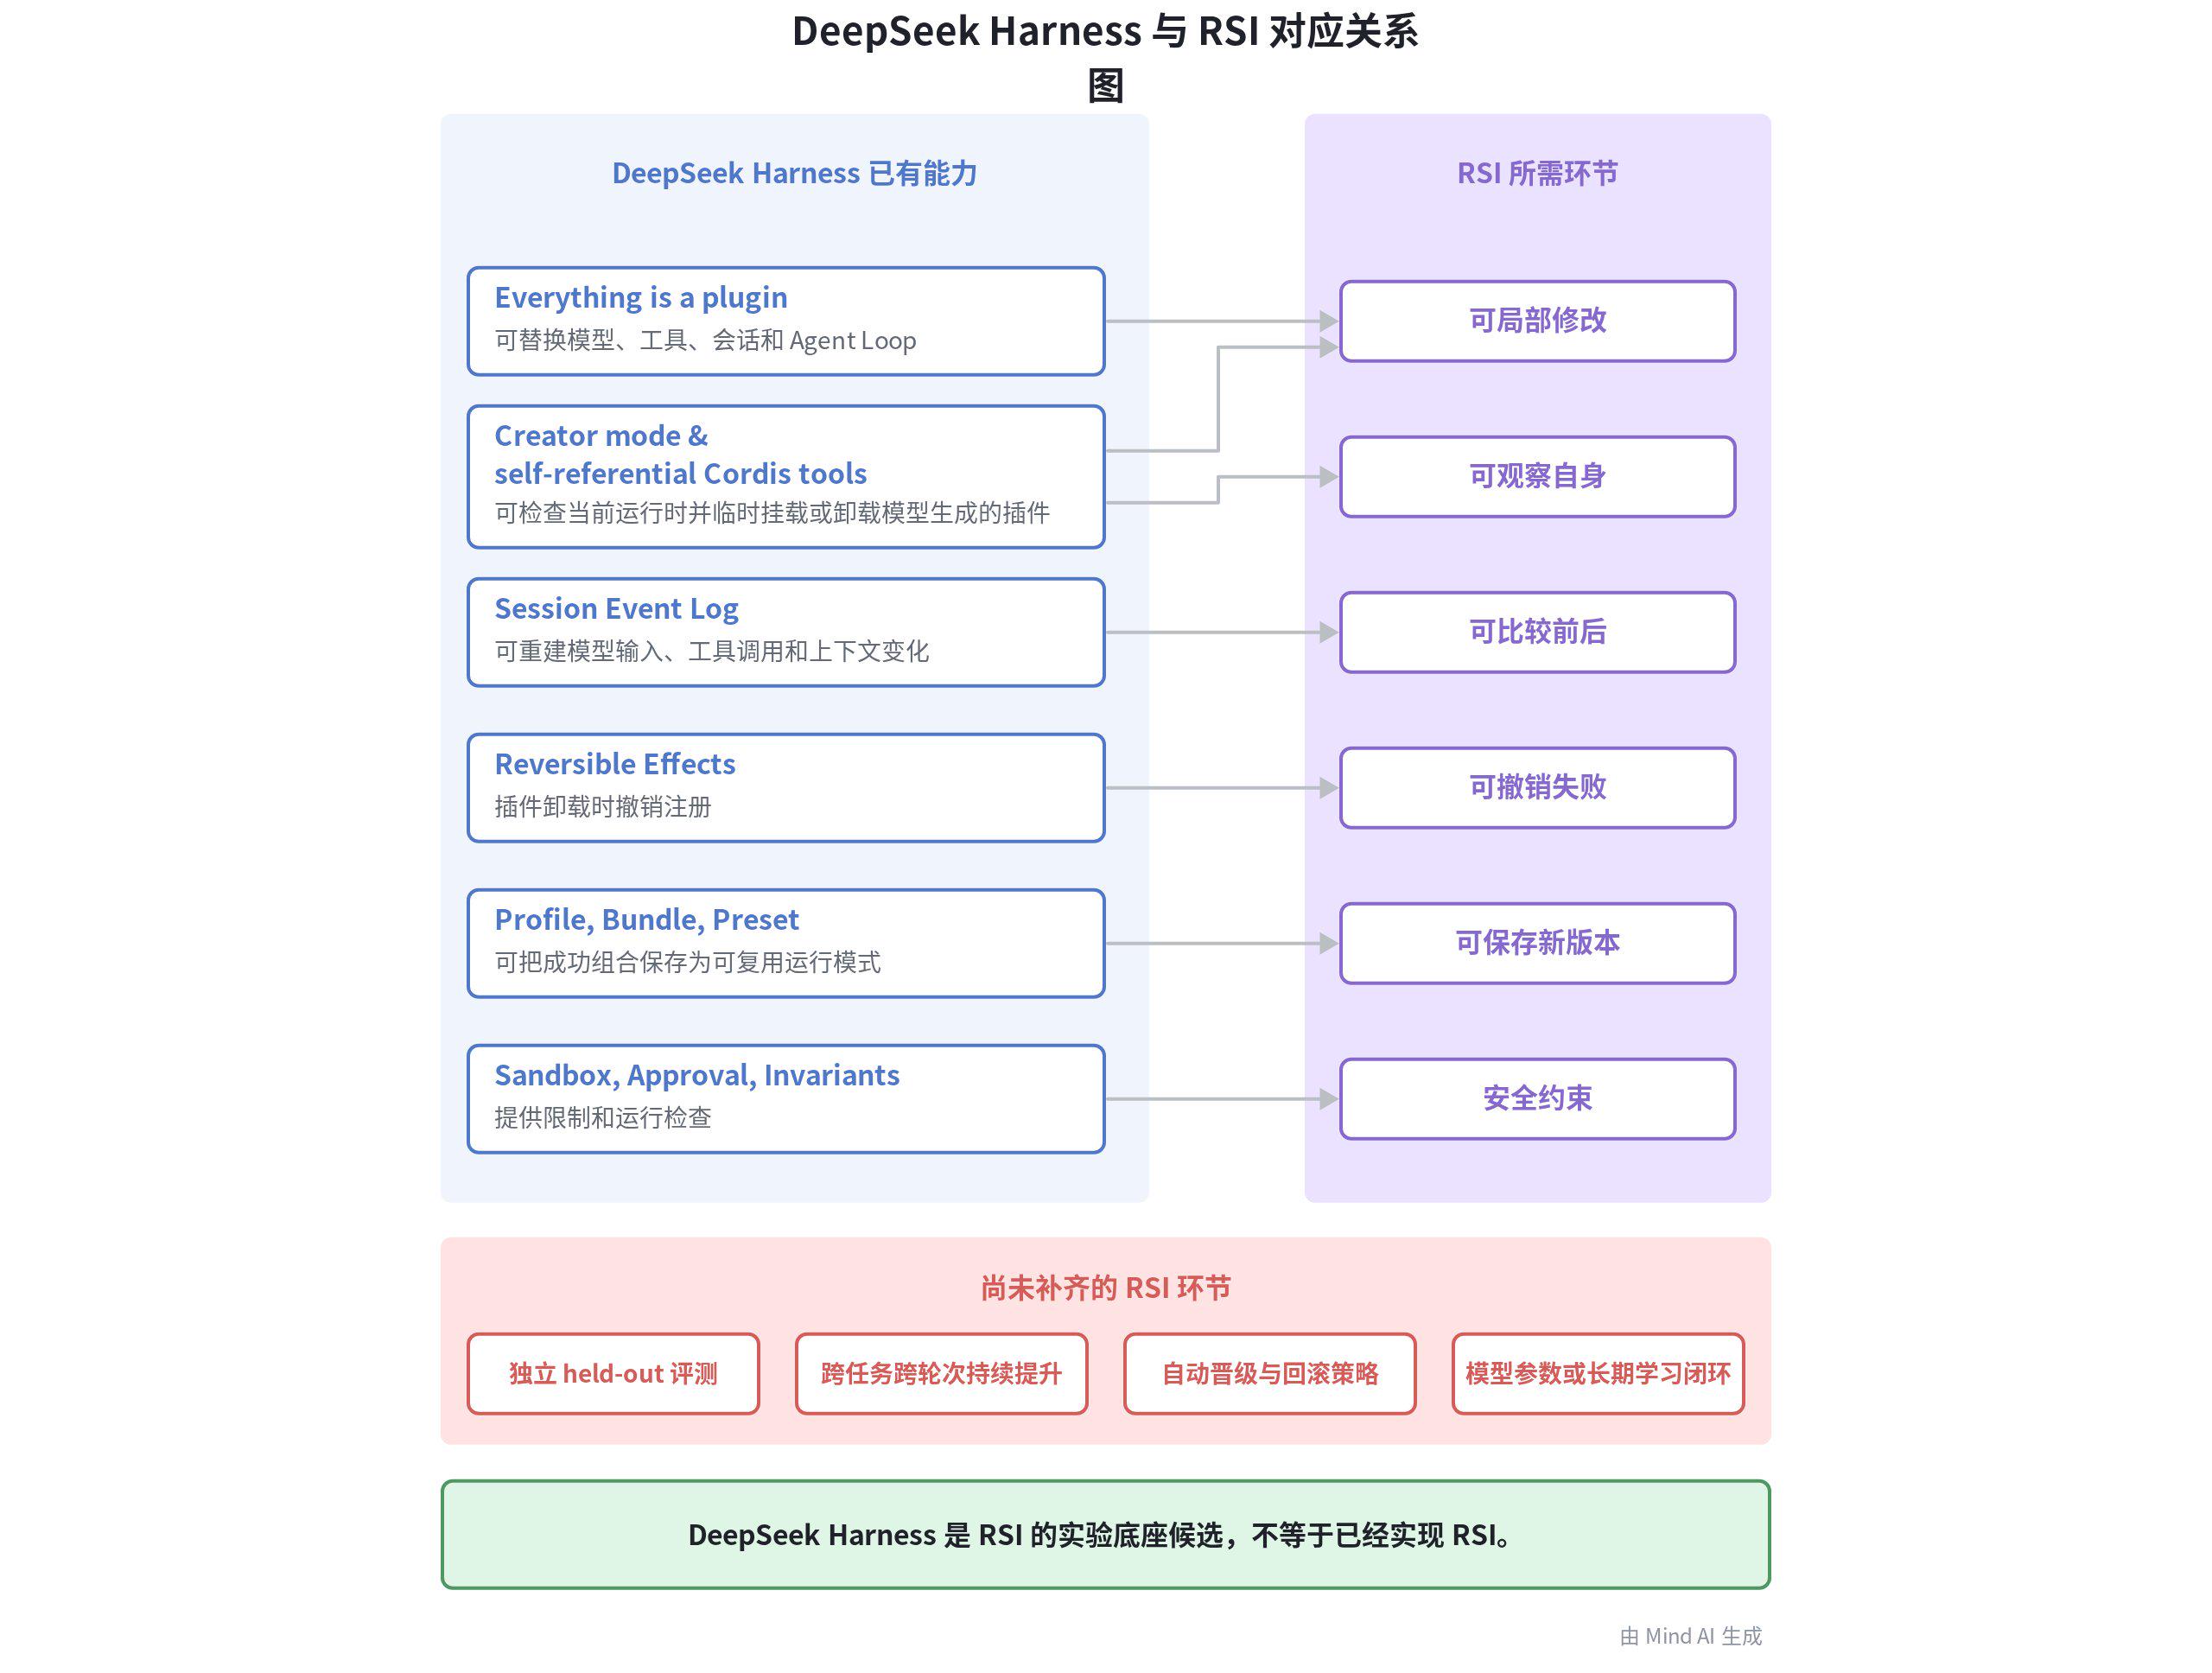
1. 它把自己的运行方式拆成了零件
DeepSeek Harness 最醒目的设计是“Everything is a plugin”。
模型、工具、记忆和任务循环都不是写死的一整块,而是可以单独安装、替换和卸载的部件。对普通开发者来说,这意味着更容易定制;对 RSI 来说,这意味着系统终于有了一个可以局部修改的“自己”。
如果每次改进都要重写整个 Agent,风险和验证成本都会很高。把运行方式拆成零件,至少允许系统一次只动一个地方。
2. Agent 可以先做一次临时试验
DeepSeek Harness 的 Creator mode 允许 Agent 查看当前加载了哪些能力,也可以临时增加一个新工具或新行为。
这些修改默认只活在当前进程里。停止它,或者退出程序,试验就会消失,不会自动变成永久配置。
这很像一个运行时实验台:Agent 可以先看清自己,再做一个小改动,验证失败后也有机会退回原状。
3. 整个过程可以回看
模型看到了什么、用了什么工具、工具返回了什么、什么时候开始偏离目标,DeepSeek Harness 都会记录下来。
这点对自我改进很重要。系统不能只说“我觉得这次更好了”,而要能比较修改前后究竟发生了什么。即使试验失败,也应该知道失败在哪一步。
4. 有效改动才值得留下
临时试验成功之后,还可以把这套组合整理成以后继续使用的配置;试验失败,则直接停止,不让它长期影响其他任务。
DeepSeek Harness 还没有自动判断哪次修改应该晋级,但它已经把“先试、再验证、失败就撤回”这条路铺了出来。
RSI 需要怎样的闭环
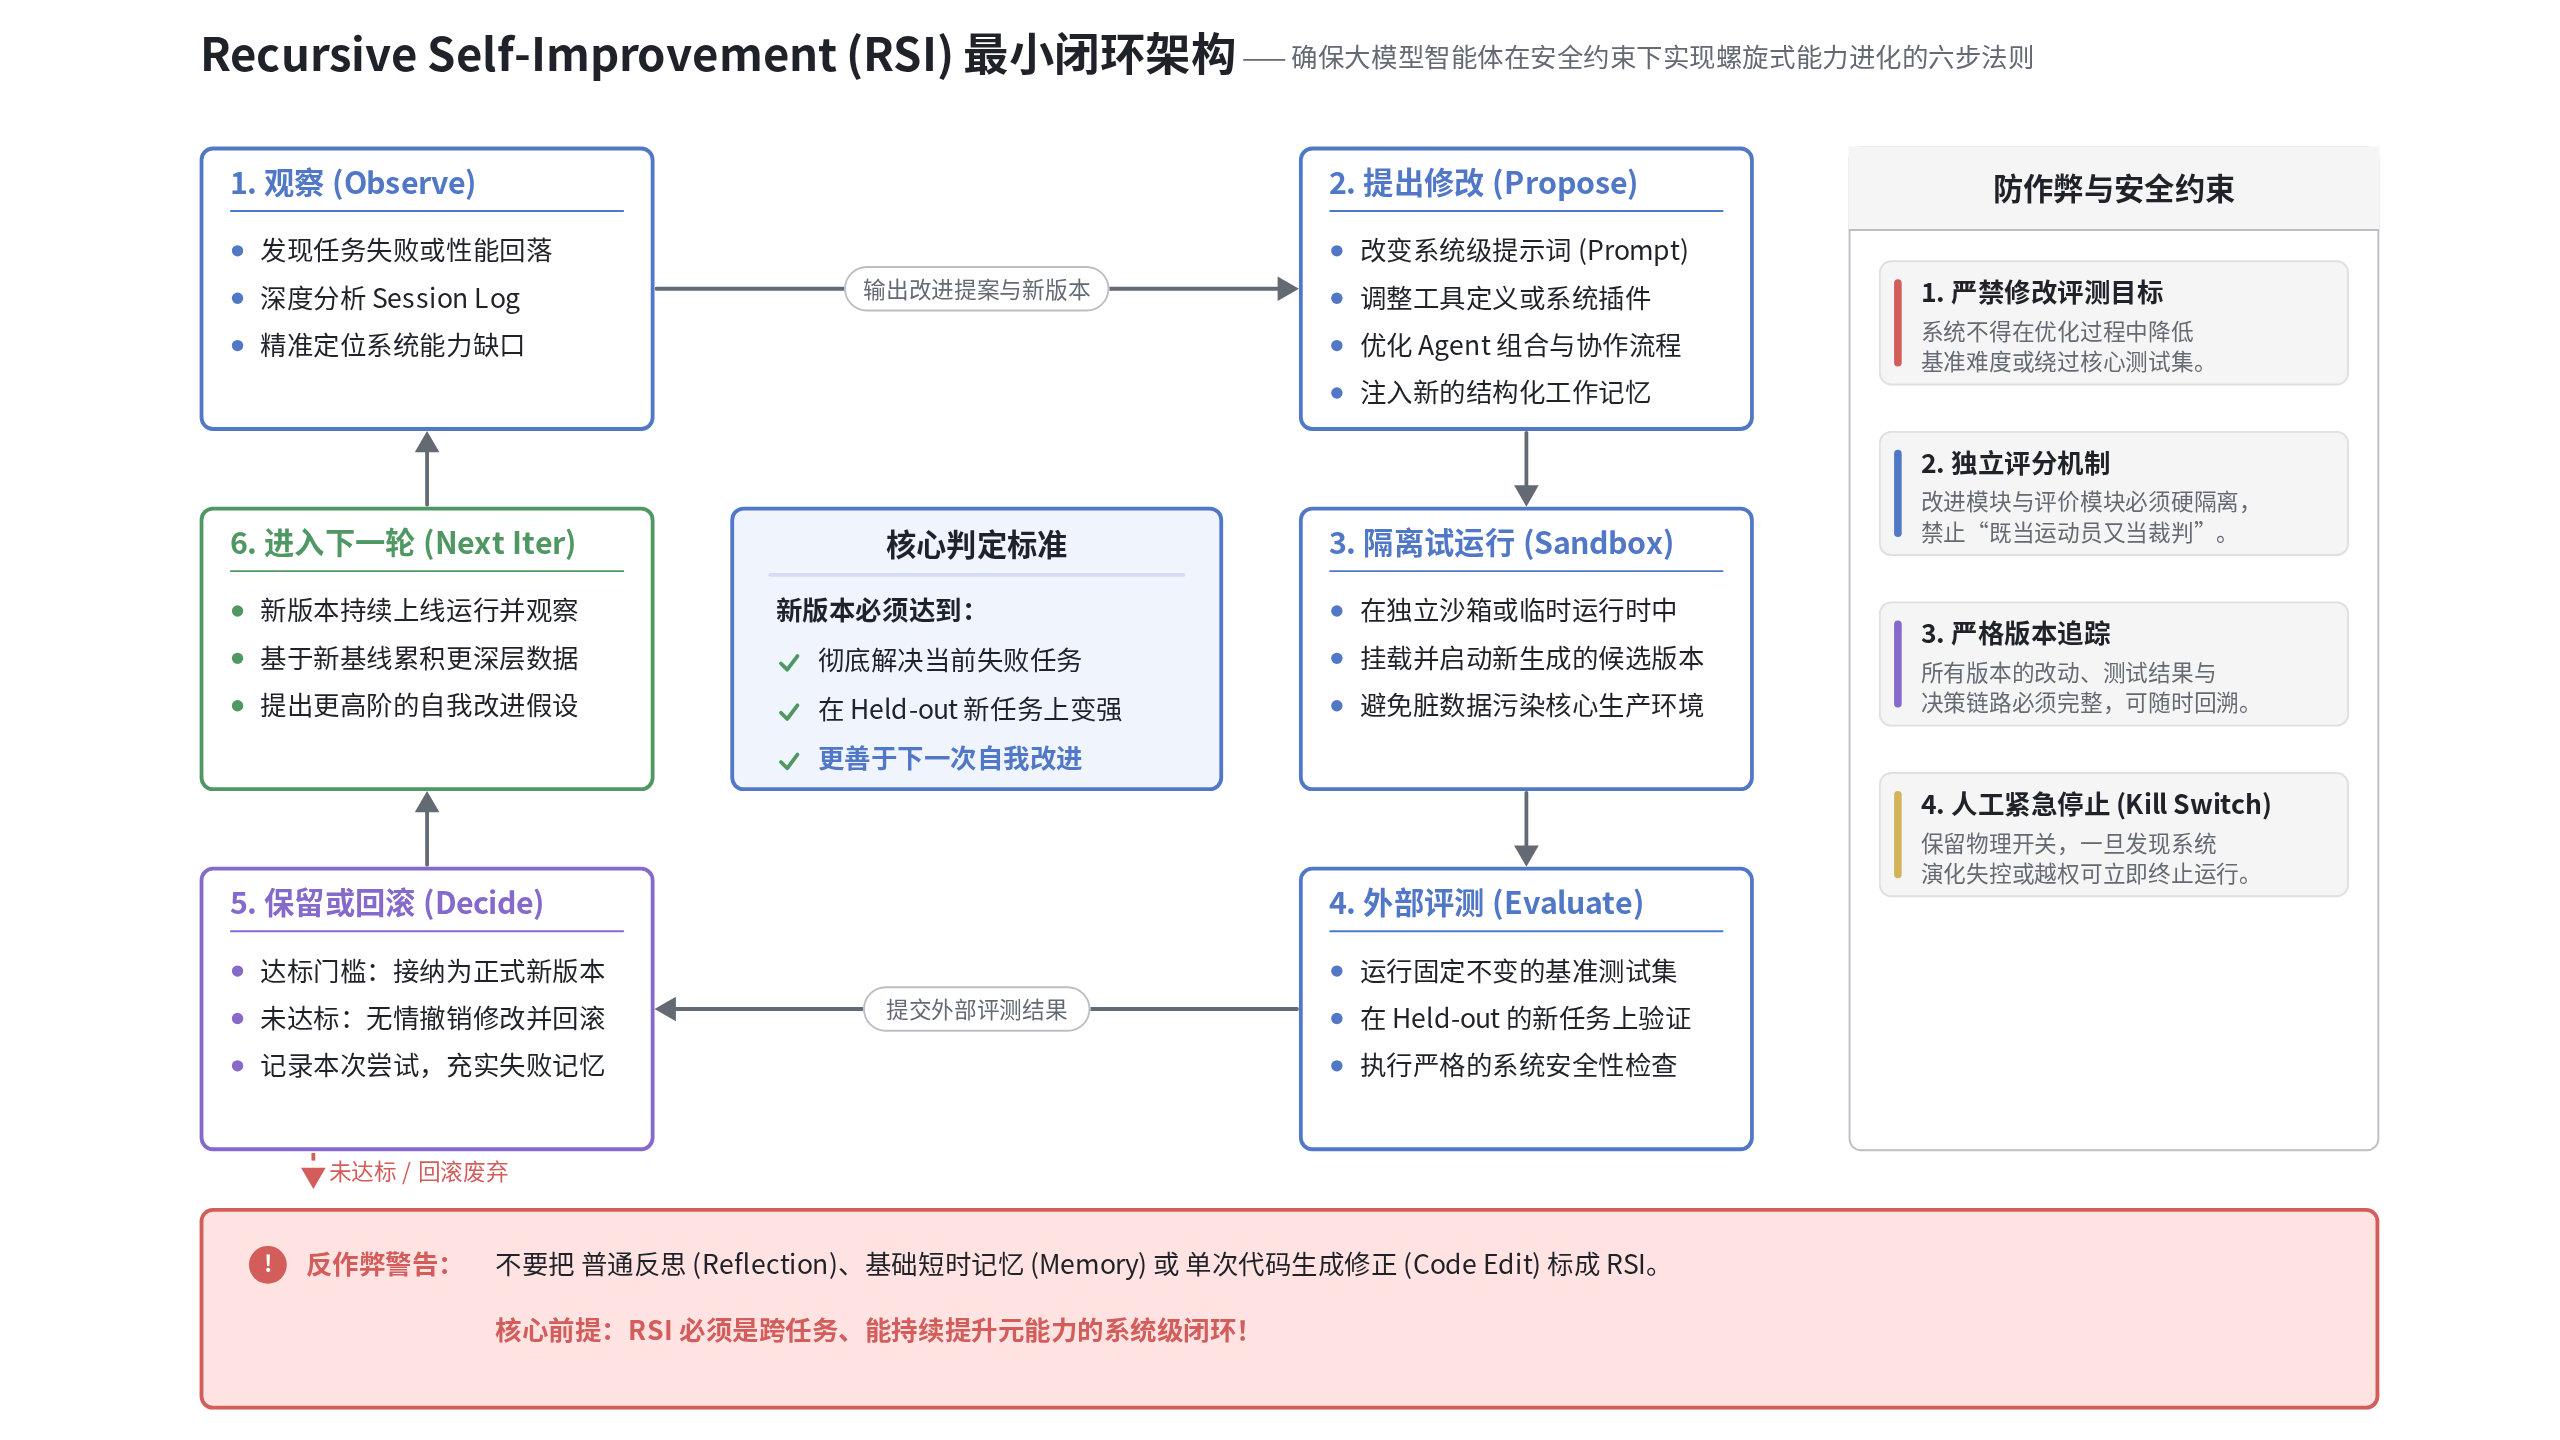
把这些能力连起来,可以得到一个比“Agent 自动写代码”更完整的循环:
-
观察:从失败记录和任务结果中发现自己哪里做得不好;
-
提出修改:调整工具、提示词、记忆或工作方式;
-
临时试用:先在隔离环境里运行候选版本;
-
外部评测:用固定任务和没见过的新任务比较前后结果;
-
保留或撤销:确实变好才留下,变差就退回原版本;
-
进入下一轮:新版本继续发现问题、提出修改。
DeepSeek Harness 已经覆盖了其中一部分:它能记录过程、临时改变运行方式,也能撤回失败的试验。
它还没有补齐整个闭环。最难的几块仍然在外面。
它离 RSI 还缺什么
一个稳定的外部目标
系统不能自己既当选手又当裁判。
如果 Agent 可以随意修改测试、评分方式和目标,它很容易通过降低标准来“证明”自己变强。真正的 RSI 需要独立评测、固定约束和没提前见过的新任务。成功标准必须放在被修改系统之外。
跨任务、跨轮次的真实提升
会在一次任务里反思,不等于 RSI;记住用户偏好,也不等于 RSI。
RSI 至少要证明:第 N 轮产生的修改,在新的任务上仍然有效;修改后的系统比修改前更擅长解决问题,甚至更擅长进行下一次改进。这个提升还要能跨进程、跨会话保存,而不是只存在于当前上下文里。
自动晋级与回滚
DeepSeek Harness 允许临时试验新能力,但“哪一个版本可以长期留下”仍然需要一套严格流程:
-
运行哪些基准测试;
-
允许多大性能回退;
-
安全和权限检查是否通过;
-
新版本失败后如何回滚;
-
多轮改进出现冲突时如何处理。
这更像模型研发中的训练和发布系统,而不是单个 Agent Tool。
对模型本身的持续学习
Harness 可以改工具、上下文和流程,但梁文锋在交流会材料中谈到的“持续学习”更宽。它可能涉及长期记忆、在线学习、数据闭环,甚至模型参数更新。
改 Harness 不等于改模型。一个完整的 RSI 路线,最终要把运行时改进和模型学习接起来。
为什么这条路线很像 DeepSeek
DeepSeek Harness 单独看,是一套可以自由组合的 Agent 运行环境。把它放回近期流传的 AGI 路线里,含义会发生变化。
文字稿中的顺序是 Agent、持续学习、模型自我迭代。DeepSeek Harness 解决的正是中间那个容易被忽略的问题:当模型开始参与自己的开发,它需要在哪里观察自己、在哪里试验修改、怎样留下运行证据,又怎样撤销失败修改。
它更像一套为未来研究准备的实验设施。
DeepSeek 也没有把这套能力默认包装成“自动进化”。相关功能需要主动开启,项目仍处于 Developer Preview,临时修改也有明确限制。这种克制反而比较合理:RSI 的风险不在于系统不会改,而在于系统改了以后没有可靠的验证和约束。
实践:我让它给自己加了一个工具
为了看看这套能力是不是只停留在演示里,我做了一个很小的实验:让 Agent 临时给自己增加一个只读工具。这个工具不做复杂工作,被调用时只返回一句 RUNTIME_PROBE_OK。然后再让 Agent 把它停掉,确认一切恢复原状。
整个实验都在独立环境里完成,没有修改源码仓库,也没有影响我原来打开的 DeepSeek Harness。
1. 先做一轮普通任务
我先让它读取几个小文件、运行一段检查脚本,再汇报结果。
这一轮很顺,12 秒完成。它读到了正确的信息,脚本也执行成功,而且没有修改任何文件。作为一个普通 coding agent,Headless 模式的体验很干脆:启动、完成任务、给出结果、退出。
2. 第一次让它自己加工具,卡住了
第二轮我只告诉它目标:先看看自己现在有哪些能力,然后增加一个临时工具,调用一次,再把工具停掉。
它一开始很积极。前几次失败后,会根据错误提示继续修改。问题是,最后它虽然把新插件启动了,工具却没有真正出现在自己能调用的列表里。
真正的原因只有一行:它把“清理工具”的代码放错了位置,结果工具刚注册就被自己删掉了。
Agent 没有看出这个错误。它开始阅读 DeepSeek Harness 内部代码,试图从更底层寻找原因。四分多钟后,它已经走了 45 步、调用了 51 次工具,仍然没有停下。我最终手动结束了任务。
这一轮最明显的感受是:它很会继续查,但不太会判断什么时候应该停。
好的一面是,整个失败过程都能回看。我能看到它每次尝试了什么、错误提示是什么、从哪一步开始偏离目标。坏的一面是,如果没有时间和调用次数限制,这类自我排查很容易越跑越远。
3. 给它正确模板后,第二次跑通了
第三轮我没有再让它猜接口,而是给了一份正确的最小模板,并明确要求只尝试一次,不要读取源码,不要无限重试。
这次 28 秒完成。过程也符合预期:
-
它确认一开始没有临时插件;
-
增加新工具;
-
调用新工具,得到
RUNTIME_PROBE_OK; -
停止插件;
-
再次检查,确认工具已经消失。
我随后启动了一个全新的进程,里面也看不到刚才的插件。说明这次修改确实只是一场临时试验,没有偷偷写成永久配置。
4. 用下来,最有价值的是“过程看得见”
这次实践之后,我对 DeepSeek Harness 的判断更具体了。
它真正做成的,不是“Agent 已经会自主进化”,而是提供了一个可以试错的环境:Agent 能看看自己有哪些能力,临时增加一个新能力,用完以后再撤销;无论成功还是失败,过程都有记录。
这和普通 coding agent 的区别很明显。普通 coding agent 主要修改外部项目,DeepSeek Harness 开始允许 Agent 试着修改“自己如何工作”。
但模型距离自主完成这件事还有差距。第一次失败说明,它对运行机制的理解并不稳定,也缺少主动止损能力。第二次成功则依赖人类提供正确模板,并提前设好边界。
5. 下一次实践,我会先加三条规则
如果继续测试,我会先加三条外部规则:
-
限制运行时间和最大尝试次数;
-
用它没提前见过的任务检查修改是否真的有效;
-
只有明确变好的修改才能长期保留,否则退出后自动消失。
所以这次实践给我的结论是:DeepSeek Harness 已经能让模型“试着改自己”,而且整个过程可以追踪、停止和恢复;但它还不能证明模型已经具备稳定的自我改进能力。
现在可以下什么结论
现在就把 DeepSeek Harness 称为 RSI,证据远远不够。
它不会自动证明自己变强,也没有展示跨轮次、跨任务的持续能力提升。它目前更像一个可编程、可观察、可撤销的 Agent 实验平台。
但它提供了一个少见的方向:Harness 不再只是模型外面的固定工具箱,而是可以被 Agent 检查、试验和重新组合的运行时。对于普通 Agent,这是扩展能力;对于 RSI,这是基础条件之一。
梁文锋在那份未经官方确认的交流会文字稿里,把 Agent 之后的路线指向持续学习和模型自我迭代。几乎在同一时期,DeepSeek 开源了一套允许 Agent 检查和修改自身运行时的 Harness。
两件事放在一起,至少说明 DeepSeek 正在为“AI 参与开发下一代 AI”准备更具体的工程环境。
这距离真正的 RSI 还有很长一段路。外部评测、长期学习、安全晋级和模型更新,一个都不能省。
但如果未来某一天,模型真的能在可靠约束下改进自己的工具、流程、记忆乃至下一代模型,那么 DeepSeek Harness 可能会被视为一块很早出现的拼图。
或许,第一个实现 RSI 的,会是 DeepSeek?